Kolik RAM potřebuje notebook pro lokální běh AI?
Malý model AI, který běží přímo na vašem notebooku, už dokáže zpracovat text i obrázky a odpovídat na vaše otázky, aniž byste potřebovali účet u cloudové služby. Dnes večer si stáhněte soubor o velikosti 3,4 GB s modelem qwen3.5:4b-q4_K_M (Qwen): na běžném notebooku s 16 GB paměti pak tento model zvládne přesně totéž. Jde o LLM, tedy velký jazykový model. Stáhněte ho přes Ollama, položte mu jednu otázku při 4K kontextu a poběží vám lokálně skutečný AI model, na hardwaru, který už máte. Pracuje s textem i obrázky a jde o inferenci, ne o trénování: model se tu nic nového neučí, jen odpovídá.
Vágní nálepka „AI PC“ na krabici notebooku není specifikace. Rozhodují RAM, paměť dostupná pro GPU, úložiště a skutečná softwarová podpora. 16 GB paměti je reálný vstupní bod pro menší AI modely, ne jen holé minimum, které můžete rovnou odepsat, ale ani příslib všeho, co slibují specifikace. Víc paměti znamená větší kontext a víc prostoru pro multitasking. Se 16 GB můžete začít.
Co při běhu AI skutečně ukrajuje RAM
Velikost staženého modelu a nároky na RAM při jeho běhu jsou dvě různé věci. Právě jejich zaměňování patří při výběru notebooku pro AI k nejčastějším chybám. Těch 3,4 GB, které stáhnete pro qwen3.5:4b-q4_K_M, je soubor na disku. K jeho načtení je potřeba skutečná operační paměť. Totéž platí pro kontextové okno, tedy průběžnou konverzaci, kterou si model během odpovídání drží v paměti, takzvanou KV cache. Paměť potřebuje i samotný engine plus všechno ostatní, co už využívá operační systém a další aplikace.
Ollama standardně načítá kontext o velikosti 4 096 tokenů a můžete ho navýšit. Pokud zpracováváte několik požadavků najednou, potřeba paměti pro kontext roste zhruba podle počtu paralelních požadavků. Specifikace modelu může uvádět kontextové okno 128K nebo 256K tokenů. Berte to jako maximum modelu, ne jako příslib, že váš 16GB notebook zvládne celý tento rozsah využít naráz.
RAM, VRAM a unified memory nejsou totéž
Čipy Apple Silicon používají unified memory: CPU i GPU čerpají ze stejné paměťové kapacity 16, 24 nebo 32 GB, takže tu není oddělená grafická paměť, která by se zaplnila dřív. Běžný notebook s Windows nebo Linuxem a samostatnou grafikou NVIDIA funguje jinak. Systémová RAM a vlastní VRAM grafické karty jsou dvě oddělené paměti a 16 GB systémové RAM plus 8GB GPU není jeden společný 24GB prostor, který může model libovolně využívat.
Když se model nevejde celý do GPU, část běží přes CPU. Říká se tomu částečný offload a i když se model technicky načte, může být znatelně pomalejší. Příkaz vám přesně ukáže rozdělení mezi CPU a GPU u toho, co je právě načtené.
Kapacita je jen polovina příběhu. Stejně důležitá je rychlost, s jakou se data v paměti přesouvají: Apple u MacBooku Air M5 uvádí propustnost paměti 153 GB/s. Právě propustnost, ne jen velikost, je důvodem, proč unified memory působí svižně, a ne jen jako technicky dostačující řešení.
Kvantizace: jak se 9B model AI zmenší tak, aby se vešel do vaší RAM
Kvantizace je důvod, proč má zmíněné stažení jen 3,4 GB: váhy modelu se ukládají s nižší číselnou přesností, a tím se soubor zmenší. U 9B modelu Qwen3.5 je to dobře vidět. Stejný 9B model má při stažení 6,6 GB jako Q4_K_M, 11 GB jako Q8_0 a 19 GB v plné přesnosti BF16. Stejný model, stejný počet parametrů, tři velmi odlišné velikosti ke stažení. A znovu platí, že jde o velikost souboru, ne o RAM potřebnou během běhu.
Nižší přesnost obvykle něco stojí na kvalitě, ale kolik přesně, záleží na konkrétní úloze, ne na nějakém pevném procentu. Jedna praktická drobnost, kterou je dobré vědět, než si zvolíte Qwen jako první model: někteří uživatelé uvádějí, že jeho krok „thinking“ přidává znatelné zpoždění, než se objeví odpověď, ve srovnání s modely, které odpovídají přímočařeji. Proto dává smysl vyzkoušet oba přístupy na vlastních úlohách, místo abyste předem předpokládali, že jeden je prostě lepší.
Máte už 16GB MacBook? Než začnete něco kupovat, vyzkoušejte nejdřív tohle
Pokud už máte 16GB MacBook, začněte s modelem 2–4B v přesnosti Q4 a 4K kontextem, než začnete cokoli kupovat. Načíst se může i 9B model v Q4 nebo něco jako Gemma 4 12B QAT. Zda to půjde, závisí na tom, kolik dalších aplikací máte otevřených, jak velký kontext používáte a jak je notebook už teď zahřátý, takže to berte jako možnost, kterou stojí za to vyzkoušet, ne jako jistotu.
Kupujete kvůli tomu nový stroj? MacBook Air 13" s čipem M5 má ve standardu 16 GB unified memory a lze ho nakonfigurovat až na 32 GB. A než vás jako upgrade zláká větší displej: 15" Air s M5 začíná na stejných variantách 16, 24 a 32 GB paměti i na stejné propustnosti 153 GB/s jako 13" verze. Velikost displeje proto vybírejte podle pohodlí, ne proto, že by vám přinesla víc prostoru pro AI. Nepřinese.

Máte 16GB notebook s Windows nebo Linuxem? Začněte tady
I 16GB notebook s Windows nebo Linuxem bez samostatné grafiky zvládne malý model. Ollama běží nativně na Windows, takže si stáhněte 2–4B model v Q4 a vyzkoušejte ho přes CPU nebo integrovanou grafiku, než utratíte cokoli navíc. Počítejte s větší rozdílností výsledků než u Apple Silicon: neexistuje jedno pevné číslo tokenů za sekundu, které by platilo pro každou sestavu, protože nikdo nezměřil všechny konfigurace.
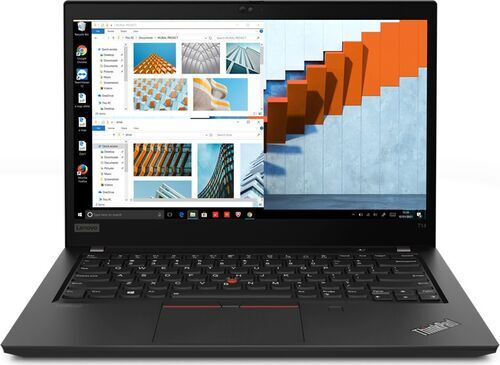
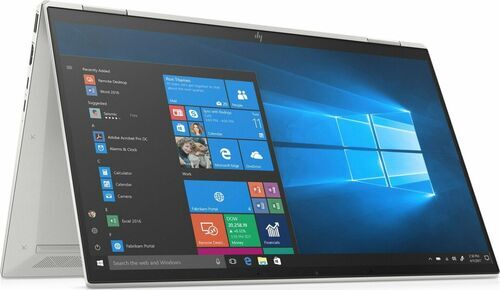
Lenovo ThinkPad T14 G2 i HP EliteBook x360 1040 G7 mají 16 GB RAM a integrovanou grafiku, tedy přesně tuto třídu. Jednu věc se ale vyplatí ověřit předem, zvlášť u staršího repasovaného produktu, jako je některý z těchto dvou modelů: LM Studio na Windows x64 vyžaduje podporu AVX2, tedy instrukční sadu, kterou nemají všechny starší procesory. Než budete předpokládat, že jakýkoli notebook v této kategorii rozběhne vámi zvolený nástroj, zkontrolujte podporu u konkrétního procesoru.
Past v názvech notebookových GPU: proč „RTX 5070 Ti“ neznamená jednu věc
GPU NVIDIA do notebooků sdílejí názvy s desktopovými kartami, ale ten název prozradí méně, než byste čekali. RTX 5060 Laptop GPU má 8 GB paměti GDDR7 a uváděný rozsah spotřeby 45 až 100 wattů. RTX 5070 Ti Laptop GPU má 12 GB GDDR7 a 60 až 115 wattů. Výsledek desktopové RTX 5070 Ti, který najdete online, není totéž jako výsledek notebookové RTX 5070 Ti, bez ohledu na to, co název naznačuje.
V tom samém názvu se skrývá ještě druhá past. Dva notebooky mohou mít oba „RTX 5070 Ti Laptop GPU“ a přesto se při dlouhodobé zátěži chovat odlišně: tenké lehké šasi a silnější těžší konstrukce odvádějí teplo jinak a stejný název GPU nezaručuje stejný reálný výkon poté, co ventilátory běží už delší dobu. Vždy proto kontrolujte přesnou kapacitu VRAM a konkrétní napájecí konfiguraci notebooku, ne jen název GPU řady.
Kupujete nový Mac? Pohodlnější třída začíná u vyšší unified memory
Pokud kupujete notebook přímo s cílem pravidelně na něm provozovat lokální AI, pohodlnější varianta u Apple začíná na 24 až 32 GB unified memory: zůstane vám skutečný prostor pro větší model, delší kontext nebo prostě pro to, abyste mohli při práci nechat otevřené další aplikace. Pokud to budete používat často a rozpočet to dovolí, sáhněte po 32 GB.
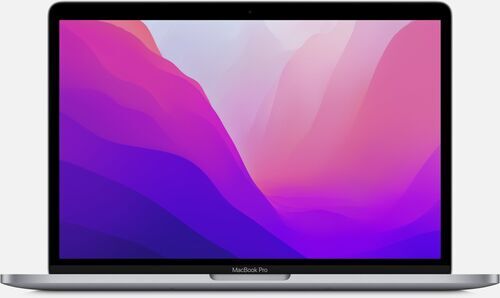
MacBook Pro 13" s čipem M2 je konkrétní repasovaný příklad, který už je nad vstupní hranicí 16 GB: jeho 8jádrové CPU a 10jádrové GPU doplňuje až 24 GB unified memory. Jde o starší generaci čipu než u Airu M5, takže zde počítejte s horní hranicí 24 GB, ne se samostatnými možnostmi 24/32 GB, které nabízí Air s M5.
Kupujete nový notebook s Windows nebo Linuxem? Hledejte samostatnou grafiku
Pokud kupujete nový notebook hlavně pro lokální AI, hledejte 32 GB systémové RAM a k tomu samostatné notebookové GPU NVIDIA s alespoň 8 GB vlastní VRAM, případně 12 GB, pokud se vám finančně vyplatí o něco těžší nebo dražší notebook. 8 GB je realistický cíl pro modely 4–7B v přesnosti Q4 se středně velkým kontextem, ale neberte to jako automatickou rezervu: i 6,6GB stažení 9B modelu v Q4 může pro pohodlný běh potřebovat víc než jen holých 8 GB a 12 GB jednoduše otevírá snazší testování v této velikosti.
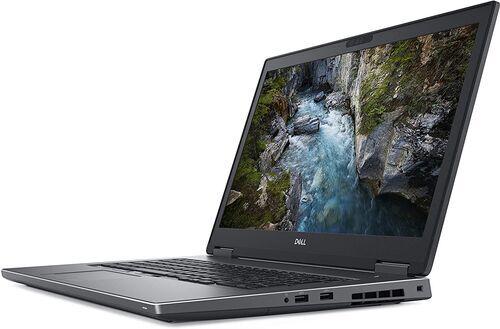
Dell Precision 7730 je konkrétní repasovaný příklad stejného principu, i když ne s přesně těmi novými čipy zmíněnými výše: 32 GB systémové paměti tu doplňuje samostatná NVIDIA Quadro P3200 s vlastní 6GB VRAM. Jde o jinou generaci a jinou třídu GPU než současné notebookové RTX 5060 a 5070 Ti od NVIDIA, ale princip oddělených paměťových kapacit zůstává stejný.

Zajímavá alternativa: notebookové čipy AMD s vysokou kapacitou paměti
Procesor AMD Ryzen AI Max+ 395 podporuje až 128 GB systémové paměti LPDDR5x, podle toho, jak je konkrétní notebook nakonfigurovaný. Jde o odlišnou paměťovou architekturu, o které stojí za to vědět, ale má jeden podstatný háček: v seznamu podpory ROCm pro Linux od Ollamy tento čip uvedený je, zatímco v aktuálním seznamu ROCm pro Windows ne.
To není důvod ten čip rovnou zavrhnout, ale je to důvod ověřit si u konkrétního notebooku přesně instalovanou paměť, operační systém, GPU backend, ovladač i chování Ollamy, než ho začnete doporučovat. Notebook s AMD a vysokou kapacitou paměti proto berte jako zajímavou alternativní architekturu, kterou stojí za to pečlivě prověřit, ne jako výchozí první nákup pro někoho, kdo s lokálním během AI teprve začíná.
Softwarová vrstva: Ollama a LM Studio bez zbytečné omáčky
Ollama je nejjednodušší cesta, jak rozběhnout model na vlastním zařízení: stáhnete model, spustíte ho a máte lokální server, který odpovídá na požadavky, bez cloudového účtu pro stažený model. Právě na tomto nástroji stojí všechny příklady zde.
LM Studio nabízí grafickou alternativu s vlastním prohlížečem modelů a chatovacím oknem. Uvádí i vlastní minima: alespoň 16 GB RAM na Macu nebo Windows, podporu AVX2 na Windows x64 a doporučené 4 GB dedikované VRAM na Windows. Správné nastavení kteréhokoli z těchto nástrojů je ale téma samo o sobě.
Ještě jedna poznámka, než začnete věřit jednomu číslu rychlosti, které někde uvidíte online: oficiální nástroj llama-bench odděluje rychlost zpracování promptu od rychlosti generování a uvádí rozptyl mezi opakovanými testy místo jediného výsledku. Příspěvek na fóru s jedním číslem tokenů za sekundu málokdy říká, kterou z těchto dvou hodnot vlastně měřil nebo kolikrát test proběhl.
Checklist pro nákup nebo upgrade notebooku připraveného na AI
Než budete kvůli lokální AI kupovat nový notebook nebo upgradovat stávající, dívejte se na konkrétní parametry, ne na marketing.
Přesný model GPU a kapacita VRAM. Ne jen název řady GPU, ale konkrétní notebooková varianta a její vlastní kapacita paměti, protože pod stejným názvem se mohou skrývat různé velikosti VRAM.
Připájená nebo rozšiřitelná RAM. U některých notebooků lze paměť doplnit později, u mnoha moderních tenkých a lehkých modelů ne. Je dobré vědět, kterou variantu kupujete.
Volné místo na SSD. Stažené modely mají od méně než 1 GB až po výrazně víc než 10 GB a rostoucí sbírka se rychle nasčítá vedle vašich dalších souborů.
Teplotní chování při delší zátěži. Jedna odpověď modelu na jednu otázku a notebook obsluhující několik požadavků za sebou jsou dva různé testy. Hluk ventilátorů a throttling po opakovaných promptech vám řeknou víc než jedna rychlá ukázka.
Podpora OS a ovladačů. Než něco předpokládáte, ověřte si, že vaše konkrétní kombinace GPU backendu a operačního systému má podporu v Ollamě nebo LM Studiu.
Hodnota NPU TOPS na krabici není zárukou propustnosti. Je to marketingový údaj, ne otestovaný výsledek z enginu, který budete používat. Vágní označení „AI PC“ nenahrazuje žádnou z výše uvedených kontrol.
Pět repasovaných notebooků, které tyto úrovně už splňují

Časté otázky k běhu AI na notebooku
Potřebuji pro lokální běh AI samostatnou grafiku?
Ne. Malý model poběží přes CPU nebo integrovanou grafiku na mnoha 16GB noteboocích, jen počítejte s většími rozdíly v rychlosti než u notebooku se samostatným GPU. Začněte s modelem 2–4B, než si řeknete, že dedikovanou grafiku vůbec potřebujete.
Bude stačit 8 GB RAM?
Ne dost pohodlně pro modely, o kterých je zde řeč. 16 GB je realistický startovní bod, jakmile započítáte model, jeho kontextové okno, engine i operační systém, které sdílejí stejnou paměť.
Je lokální spuštění modelu totéž jako jeho trénování?
Ne. Vše výše popsané je inference, tedy kladení otázek už natrénovanému modelu. Trénování vytváří model od začátku a vyžaduje výrazně víc hardwaru, než má kterýkoli notebook uvedený zde.
Zaručí více RAM rychlejší odpovědi?
Ne. Víc paměti přináší rezervu pro větší modely, delší kontext a více otevřených aplikací, ale skutečná rychlost závisí na propustnosti paměti, GPU backendu a konkrétním modelu, ne jen na samotné velikosti paměti.
Jsou moje data soukromá, když model běží lokálně?
Ano, v tom smyslu, že vaše prompty zůstávají na vašem zařízení a neodcházejí ke cloudovému poskytovateli. Ollama je ve výchozím nastavení navázaná na váš vlastní notebook a neposílá požadavky nikam jinam, pokud si záměrně nenastavíte cloudový přístup.
Vyzkoušejte si to dnes večer a pak nakupujte bez obav
Máte už 16GB notebook? Nainstalujte si dnes večer Ollamu a spusťte jeden malý model, než utratíte jedinou korunu za něco nového. Kupujete kvůli tomu nový stroj? Vezměte checklist výše a pět právě zmíněných repasovaných notebooků jako výchozí srovnání, ne jako marketingovou tabulku specifikací.
Každý notebook na refurbed prochází před zařazením do nabídky testováním a zařazením do stavu produktu, takže RAM a konfigurace, které kupujete, jsou přesně ty, které dostanete. Další průvodce z této série vás provede připojením první aplikace k modelu, který jste si právě vyzkoušeli.


Přihlas se k odběru našich novinek a ušetři 400 Kč!
Už nikdy nepromeškej žádnou nabídku.
Informace o použití osobních údajů najdeš v našich Zásadách ochrany osobních údajů.
Stáhni si aplikaci refurbed
Pro iOS a Android


Potvrď registraci.
Kliknutím na odkaz v potvrzovacím e-mailu, který jsme ti právě poslali, obdržíš poukaz. Voucher platí pro nákupy od 5000 Kč.
- © Refurbed Marketplace GmbH
- Přístupnost
- VOP
- Zásady ochrany osobních údajů
- Impressum
- Právní upozornění
- European Data Act
- Cookie Policy