Nejlepší malé AI modely pro notebook: sestavte si lokální sadu
Na běžném notebooku se 16 GB paměti už qwen3.5:4b-q4_K_M odpovídá na otázky zcela bez internetu. Je to model ze druhého dílu této série a jako univerzální asistent se osvědčuje. Neměl by ale zároveň vyhledávat ve vašich souborech a řešit programátorské úlohy. Když od jednoho staženého modelu čekáte všechno, snadno ho přetížíte. Lepší je sestavit trojici malých modelů, z nichž každý má svůj úkol a musí se při něm osvědčit.
Mít lokální AI pod kontrolou znamená vědomě se rozhodnout, který model a nástroj pro jeho spouštění použijete, jakou zvolíte licenci a kde která data zůstanou. Pokud ještě nevíte, kolik RAM a VRAM váš notebook má, začněte článkem kolik RAM potřebuje notebook pro lokální AI. Jestli jste dosud nenainstalovali Ollamu, provede vás tím návod na zprovoznění první lokální AI. Tady už počítáme s tím, že obojí máte hotové. Teď zbývá vybrat modely a poznat, které stojí za to.
Nejlepší malé AI modely podle toho, co potřebujete
Užitečná sada pro lokální AI pokryje tři různé úlohy. Nemusí je všechny zvládnout jediný model.
Univerzální asistent pro běžný chat, psaní návrhů a rychlé otázky: qwen3.5:4b-q4_K_M. Soubor ke stažení má 3,4 GB a jde o stejnou variantu jako ve druhém dílu.
Malý specialista pro užší úlohu, třeba výstup v přesně daném formátu nebo uvažování podle zadaných omezení: granite4.2:3b. Soubor ke stažení má 2,2 GB, model vyšel v srpnu 2026 a vztahuje se na něj licence Apache 2.0. V šesté části najdete další specialisty na programování, matematiku, práci s obrázky a překlad. Tento model tak můžete v sadě vyměnit podle toho, co potřebujete řešit.
Model pro tvorbu embeddingů pro hledání ve vlastních dokumentech: embeddinggemma:300m o velikosti 622 MB. S tímto modelem si nepopovídáte. Převádí text na vektory, ve kterých pak vyhledává příslušná aplikace. Podrobně se k tomu vrátíme v osmé části.
Všechny tři soubory zaberou na disku dohromady přibližně 6,2 GB. Neznamená to však, že jim při běhu stačí stejně velký společný příděl paměti: když necháte načtené všechny tři najednou, může notebooku dojít volná paměť. Na každý úkol proto načtěte jeden model, vyzkoušejte ho při skutečné práci a ten, který se neosvědčí, smažte.
Co mění kvantizace
Co kvantizace mění, nejlépe ukazují varianty téhož modelu. Ollama uvádí qwen3.5:9b-q4_K_M o velikosti 6,6 GB, qwen3.5:9b-q8_0 s 11 GB a qwen3.5:9b-bf16 s 19 GB. Váhy modelu jsou stejné, liší se však přesnost jejich uložení a velikost souboru ke stažení.
Jde o velikosti souborů uvedené v katalogu, nikoli o zaručenou spotřebu paměti při běhu. Nižší přesnost šetří místo na disku a často i paměť po načtení. Zda se tím zhorší kvalita odpovědí, záleží na modelu, způsobu kvantizace a úloze. Nepočítejte tedy s tím, že rozdíl v kvalitě nenastane ani že je úspora bez kompromisů.
Samotné načtené váhy navíc nejsou všechno. Paměť potřebuje také kontextové okno a jeho mezipaměť klíčů a hodnot, stejně jako ostatní spuštěné programy. Úspora díky kvantizaci proto sama o sobě nezaručí, že se větší model do paměti vejde. Dává vám jen větší šanci, než kdybyste nejprve zkoušeli soubor v plné přesnosti.
Dva názvy, kvůli kterým snadno stáhnete jiný model
Dvě označení v katalogu svádějí k chybnému odhadu toho, co se vám stáhne.
První chyták. Google na kartě modelu Gemma 4 E2B uvádí 2,3 miliardy „efektivních“ jazykových parametrů. Mohlo by se tedy zdát, že půjde o malý soubor. V Ollamě má ale tento model ke stažení 7,2 GB, téměř tolik jako varianta gemma4:12b Q4 se 7,6 GB. Když zjišťujete, co se do notebooku vejde, řiďte se velikostí souboru ke stažení, ne počtem parametrů.
Druhý chyták. Neúplný název může bez upozornění vybrat jinou variantu modelu. Pokud stáhnete jen granite4.2, získáte model 8B o velikosti 5,3 GB, ne variantu 3B s 2,2 GB z druhé části. Pod samotným názvem qwen3-embedding se zase stáhne model 8B o velikosti 4,7 GB, nikoli varianta 0.6B se 639 MB, kterou používáme v osmé části.
V obou případech pomůže totéž: stahujte model pod úplným a přesným označením, ne jen pod názvem celé rodiny. Než začnete testovat, zkontrolujte také velikost stahovaného souboru.
Jak dlouhý kontext Ollama nastaví ve výchozím stavu
Údaj o maximu 128K nebo 256K tokenů v katalogu říká, jak dlouhý kontext model v principu zvládne. Neznamená, že si takový kontext můžete dovolit na notebooku se 16 GB paměti.
Ollama ve výchozím nastavení používá kontext o délce 4 096 tokenů. Můžete ho prodloužit, ale s délkou kontextu i počtem souběžných požadavků roste spotřeba paměti. Nastavení num_ctx: 4096 ze druhého dílu odpovídá právě této opatrně zvolené výchozí hodnotě, nejde o nahodilé kulaté číslo.
Nový model začněte zkoušet s kontextem 4–8 tisíc tokenů a vždy jen v jedné relaci. Průběžně sledujte využití paměti. Kontext prodlužujte, až když vidíte, že spotřeba zůstává stabilní, ne jen proto, že katalog připouští vyšší maximum.
Který malý AI model zvolit pro konkrétní úkol
Jeden nejlepší specialista pro všechny úlohy neexistuje. Rozhoduje úkol, který máte před sebou, a to, jak se při něm menší modely osvědčí.
Programování: qwen2.5-coder:3b (1,9 GB) nebo větší qwen2.5-coder:7b (4,7 GB). Na oba se vztahuje licence Apache 2.0.
Matematika nebo logika se zadanými omezeními: phi4-mini:3.8b (2,5 GB) od Microsoftu.
Dotazy k obrázkům a snímkům obrazovky: gemma4:e2b (7,2 GB) nebo gemma4:12b Q4 (7,6 GB). Oba mají licenci Apache 2.0 a podle katalogu přijímají text i obrázky.
Psaní ve více jazycích nebo překlad: aya-expanse:8b (5,1 GB), vytvořený pro 23 jazyků.
U poslední možnosti je důležité upozornit na licenci. Pro Aya Expanse 8B platí CC-BY-NC-4.0 s dalšími podmínkami a model je určen pro nekomerční použití. Nepovažujte ho proto automaticky za stejně volnou volbu jako výše uvedené modely s licencí Apache 2.0. Pokud se pro vaši úlohu nehodí žádná z těchto čtyř možností, pro obecnější úlohy vyžadující úsudek zůstává volbou granite4.2:3b z druhé části.
Než si některý model necháte, vyzkoušejte ho na vlastní práci. Specialista si musí své místo obhájit stejně jako univerzální asistent: tím, že vám pomůže s konkrétním úkolem, ne umístěním v cizím žebříčku.
Než modelu uvěříte, vyzkoušejte ho na pěti úkolech
Pět krátkých zkoušek vám o modelu řekne víc než stránka v katalogu. Každému kandidátovi zadejte stejných pět úkolů a použijte vlastní podklady.
1. Shrnutí opřené o zdroj. Předložte modelu poznámku o délce 250 slov a chtějte tři úkoly k vyřízení. U každého ať uvede větu, ze které vychází. Označte všechna tvrzení, pro která v textu nenajdete oporu.
2. Přesné vypsání údajů. Vymyslete pět schůzek se jmény a daty. Požádejte o výstup ve formátu JSON s přesně určenými poli a všech pět položek pak porovnejte se zadáním.
3. Oprava kódu. Dejte modelu jednu malou funkci, která neprochází testem, a jeden test. Zaznamenejte, zda po navržené opravě test projde. U všech porovnávaných modelů zachovejte stejný repozitář i kontext.
4. Dvojice jazyků. Nechte člověka, který cílovým jazykem plynně mluví, ověřit, zda si překlad realistického odstavce zachoval jména, čísla a významové odstíny. Vícejazyčné schopnosti neposuzujte jen podle zadání v angličtině.
5. Otázka k obrázku, pouze pro modely pracující s obrazem. Ukažte jim graf nebo snímek obrazovky s ověřitelnou odpovědí. Přesvědčte se, že model dostal samotný obrázek, ne jen název jeho souboru.
Při každém pokusu si zapište, zda odpověď souhlasí s tou známou, zda model dodržel pokyny a zda si něco nevymyslel. Zaznamenejte také čas do prvního viditelného výstupu, celkový čas, počty tokenů a to, zda výpočet běžel na CPU, nebo GPU. Užitečnost a rychlost hodnoťte zvlášť: model, který před odpovědí uvažuje, může strávit nezanedbatelný čas zpracováním tokenů, které nikdy neuvidíte.
Jak do malé sady přidat hledání v dokumentech (lokální RAG)
Model pro tvorbu embeddingů z druhé části má jediný úkol: převádět text na vektory, ve kterých může vyhledávat příslušná aplikace. Sám na otázky neodpovídá.
Na pořadí kroků záleží. Vaše soubory se rozdělí na úryvky a model každý z nich převede na vektor. Vektory se uloží v lokálním vektorovém úložišti. Na vektor se převede také váš dotaz; podle něj se vyhledají nejbližší úryvky. Teprve pak odpoví chatovací model, který z nalezených pasáží vychází a cituje je.
Chatovací model se na vašich dokumentech nikdy netrénoval. Ve chvíli, kdy položíte otázku, vidí jen to, co mu předá vyhledávací krok.
Princip si můžete ověřit bez složité přípravy: zařaďte do vyhledávání pět poznámek, které už máte. Položte jednu otázku s odpovědí v některé z nich a druhou, na kterou není odpověď nikde v této pětici. Funkční sestava u první otázky najde a ocituje správnou pasáž. U druhé přizná, že nemá podklady, místo aby si odpověď vymyslela. Kvalitu vyhledání a konečné odpovědi posuzujte odděleně.
Než model pro tvorbu embeddingů stáhnete, ověřte jeho úplné označení: embeddinggemma:300m nebo qwen3-embedding:0.6b. Důvod je stejný jako u neúplných názvů ve čtvrté části.
Méně aktivních parametrů neznamená méně dat k uložení
Model označený například jako „26B A4B“ zapojuje při generování každého tokenu jen část svých parametrů. Váhy všech 26 miliard parametrů ale stejně musí být někde uložené nebo se průběžně načítat. Méně aktivních parametrů tedy neznamená menší soubor ani automaticky nižší spotřebu paměti.
V této sadě neuvádíme žádná nově naměřená čísla z výkonnostních testů. Pokud údaj pochází odjinud, berte ho jako výsledek konkrétní sestavy, ne jako obecné očekávání. Příkladem je zpráva jednoho člověka o rychlosti zhruba 18,5 tokenu za sekundu u neobvyklé sestavy s modelem typu mixture-of-experts o 26 miliardách parametrů, starším CPU a GPU se 6 GB paměti. Stejnou rychlost nelze očekávat od každého modelu s tímto označením.
Na kterých noteboocích jsme sadu zkoušeli
Tuto sadu jsme ověřovali na dvou konkrétních noteboocích ze druhého dílu série, které jsou nyní v nabídce: na základním modelu s čipem Apple Silicon a na pracovní stanici s Windows a vlastní vyhrazenou grafickou pamětí. Oba se na refurbed prodávají jako repasované, tedy odborně otestované, vyčištěné a znovu připravené k používání. Na oba se vztahuje 12měsíční záruka a tuto sadu si na nich můžete pohodlně vyzkoušet, vždy jeden model najednou.
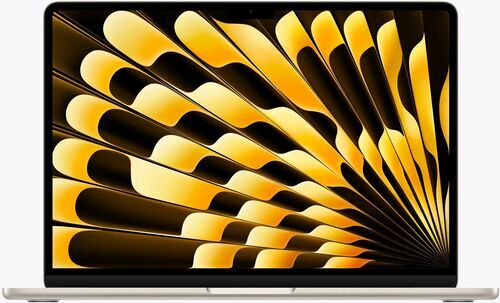
13palcový MacBook Air (2026) s čipem M5 má standardně 16 GB sdílené paměti a lze jej nakonfigurovat až s 32 GB. Dell Precision 7730 kombinuje 32 GB systémové paměti s vlastními 6 GB vyhrazené paměti NVIDIA VRAM. Jde o dvě oddělené paměti, jejichž kapacity nelze prostě sečíst.
Neuvádíme je jako pobídku ke koupi. Na těchto konkrétních noteboocích jsme návod ověřovali, abyste s nimi mohli porovnat svůj stroj místo toho, abyste se řídili jen marketingovou tabulkou parametrů.

Pohlídejte si licence a nechte si jen modely, které využijete
Licence se vztahuje ke konkrétnímu modelu, ne automaticky k celé rodině. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B a Gemma 4 E2B mají licenci Apache 2.0. Pro Aya Expanse 8B platí CC-BY-NC-4.0 s dalšími podmínkami a nekomerčním použitím, jak už zaznělo v šesté části. Možnost stáhnout váhy modelu, svolení držitele autorských práv k jejich používání a to, že podkladový model „vlastníte“, jsou tři různé věci. Kontrolujte proto aktuální kartu přesně té varianty, kterou stahujete, ne jen název její rodiny.
Udržet sadu malou není jednorázové rozhodnutí. Příkaz ollama rm odstraní stažený model, pro který jste nenašli využití. Například ollama rm aya-expanse:8b použijete, až budete vědět, že tento model potřebovat nebudete. ollama ls ukáže, co máte na disku, a ollama ps, co je právě načtené. Katalogy se mění, proto svůj výběr čas od času přehodnoťte, místo abyste spoléhali na rozhodnutí staré několik měsíců.
I malé modely si mohou vymyslet pasáž, přehlédnout významový odstín v jiném jazyce nebo napsat kód, který vypadá správně, ale neprojde testem. Každé zdejší doporučení si proto sami ověřte. U důležitých věcí nenahradí kontrolu odborníkem.
Časté otázky o malých AI modelech pro lokální provoz
Mohu mít spuštěné všechny tři modely najednou? Na notebooku se 16 GB paměti pravděpodobně ne tak, aby se vám s nimi pohodlně pracovalo. Na aktuální úkol načtěte jeden model a pak ho vyměňte, místo abyste univerzálního asistenta, specialistu i model pro tvorbu embeddingů nechávali v paměti současně.
Potřebuji k modelu pro tvorbu embeddingů GPU? Ne. embeddinggemma:300m je dost malý na to, abyste ho vyzkoušeli pouze na CPU. Přesto si změřte dobu běhu a nepředpokládejte, že vše proběhne okamžitě.
Dá větší model vždy lepší odpověď? Ne. Zda si při konkrétní úloze povede lépe model 4B, nebo 9B, záleží právě na té úloze. Proto sedmá část nabízí postup s pěti testy, ne jediné číslo z žebříčku.
Stačí varianta Q4? Záleží na úloze. Pokud máte dost paměti na spuštění obou variant, porovnejte Q4 s odpovídající Q8 ve třech vlastních testech, jak popisuje třetí část.
Mohu Aya Expanse použít v komerčním projektu? Bez dalšího ne. Licence CC-BY-NC-4.0 se vztahuje na nekomerční použití a má další podmínky. Než budete předpokládat něco jiného, zkontrolujte aktuální kartu modelu.
Potřebuje model pro tvorbu embeddingů po stažení internet? Ne. Stejně jako ostatní modely v této sadě běží bez připojení, jakmile máte jeho váhy uložené na disku.
Teď je řada na vás: nainstalujte modely a nechte si ten užitečný
Na notebooku, jehož paměťové možnosti jste posoudili s pomocí prvního dílu a na kterém jste podle druhého dílu nastavili Ollamu, nainstalujte asistenta 4B a jednoho specialistu pro úkol, který potřebujete řešit. Udělejte si vlastní verzi testu ze sedmé části se třemi otázkami. Ponechte si model, který vám pomůže, a druhý odstraňte příkazem ollama rm. O větší paměti uvažujte, až když při konkrétní práci zjistíte, že vás omezuje právě její kapacita, ne jen podle tabulky parametrů.
Tím naše třídílná série končí. Pokud jste zjistili, že váš notebook nejprve potřebuje víc paměti, můžete začít hledat v kategorii notebooků.

Přihlas se k odběru našich novinek a ušetři 400 Kč!
Už nikdy nepromeškej žádnou nabídku.
Informace o použití osobních údajů najdeš v našich Zásadách ochrany osobních údajů.
Stáhni si aplikaci refurbed
Pro iOS a Android


Potvrď registraci.
Kliknutím na odkaz v potvrzovacím e-mailu, který jsme ti právě poslali, obdržíš poukaz. Voucher platí pro nákupy od 5000 Kč.
- © Refurbed Marketplace GmbH
- Přístupnost
- VOP
- Zásady ochrany osobních údajů
- Impressum
- Právní upozornění
- European Data Act
- Cookie Policy